들어가며
가상 면접 사례로 배우는 생성형 AI 서비스 설계 책을 읽고, 4장 'ChatGPT: 개인 비서 챗봇'에서 이해한 내용을 정리했습니다.
ChatGPT는 오픈AI가 2022년에 출시한 챗봇으로 주어진 입력값을 기반으로 실제 사람이 작성한 듯한 글을 생성합니다. 출시한지 3개월 만에 1억 명 이상의 사용자를 확보했단느 점에서 아주 빠른 시간 내에 역사상 가장 많이 활용된 애플리케이션 중 하나가 되었습니다. 이러한 빠른 성장세는 생성형 AI가 가진 능력 뿐만 아니라 일상적인 과제 및 생산성 향상 측면의 잠재력을 보여줍니다.
이번 장에서는 이런 ChatGPT와 같은 챗봇을 구축하기 위한 핵심 요소에 대해 알아보겠습니다.
1. 요구사항 구체화
챗봇을 설계하기 앞서 먼저 어떤 범위까지 구현한 서비스인지 구체화 할 필요가 있습니다.
- 언어지원
- 콘텐츠 알고리즘
- 작업의 범위
- 후속 질문과 대화 맥락 정도
여기서는 영어에 집중한 텍스트로만 질의응답가능한 서비스이고 하나의 대화 세션 내에서 발생하는 후속 질문에 대답할 수 있어야 하는데 최소 4096개 토큰의 컨텍스트 윈도를 가진다고 가정합니다. 여기서는 웹사이트 탐색, 외부 api호출, 온라인 검색 등을 하지 않고 개인화 상호작용도 제외한 지시기반 80,000개의 데이터 세트가 있다고 가정하겠습니다.
2. 머신러닝 관점으로 문제 정의하기
시스템의 입력과 출력 구체화하기
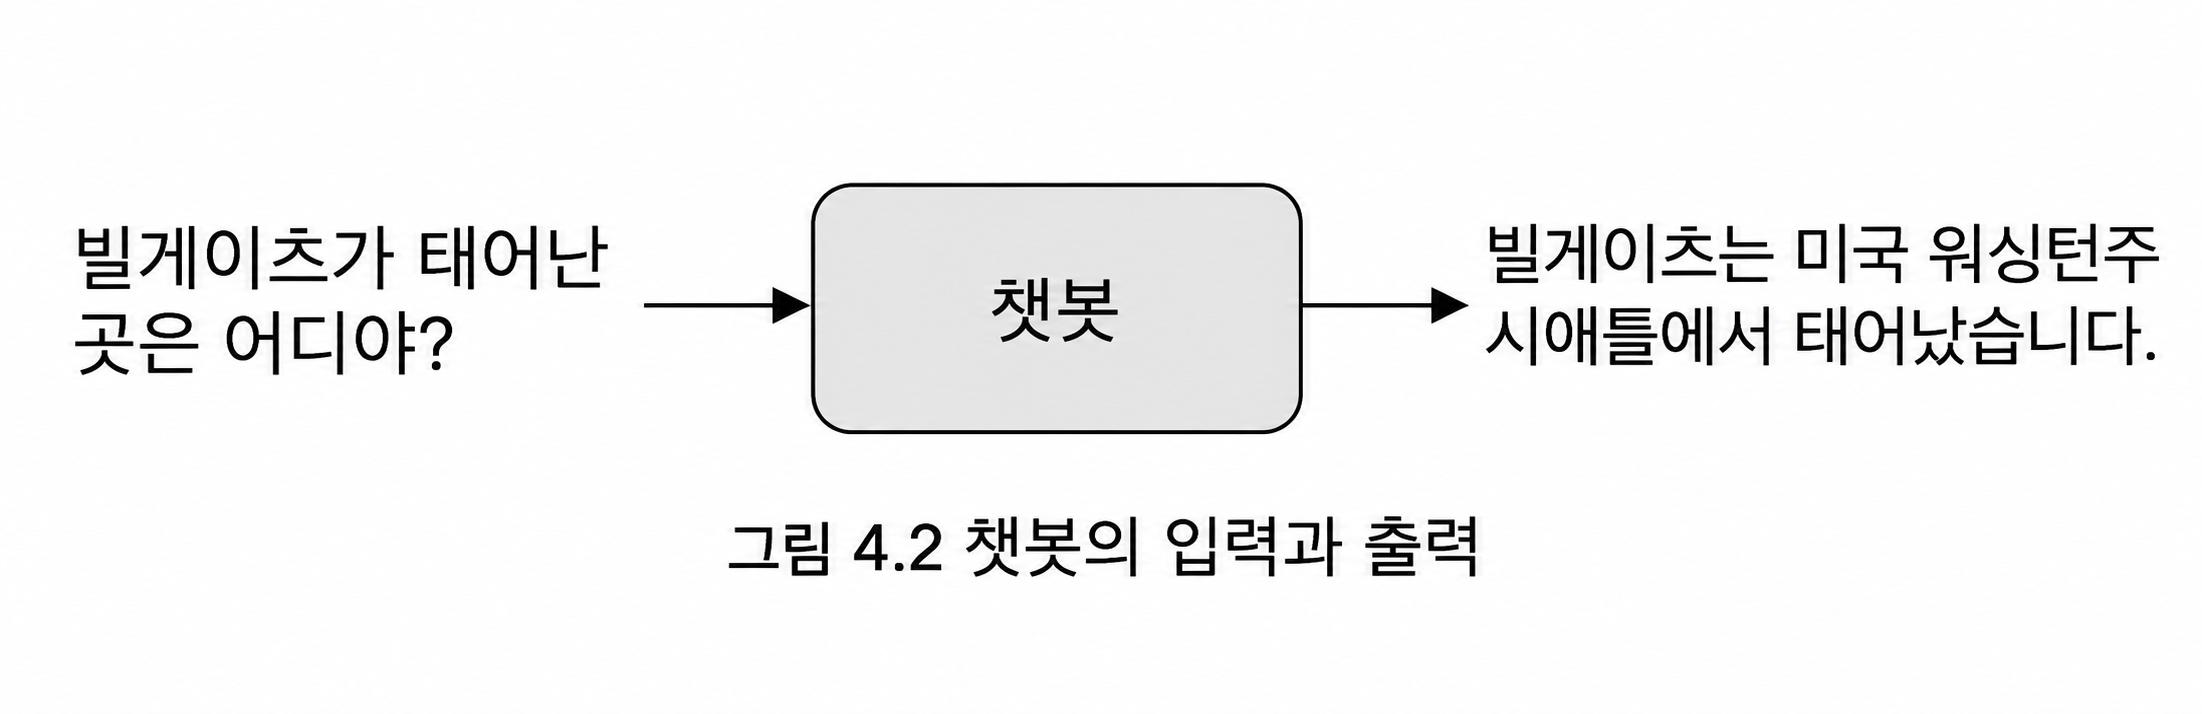
챗봇의 입력은 사용자가 제공하는 텍스트 프롬프트입니다. 출력은 챗봇이 생성하는 맥락상 적장하고 관련성이 높은 답변입니다.
적절한 머신러닝 방법 선택하기
챗봇은 언어모델을 사용하여 입력 프롬프트를 처리하고 응답을 만들어내는 텍스트 생성 작업을 수행합니다. 언어 모델을 효과적으로 학습하려면 수십업 개의 매개변수가 필요하기에 LLM이라고 부릅니다,
언어 모델의 대표적인 구조는 디코더 전용 트랜스포머입니다. GPT, Gemini, Llama와 같은 대부분의 최신 LLM은 디코더 전용 트랜스포머에 기반합니다. 이런 모델과 마찬가지로 디코더 전용 트랜스포머를 활용해 챗봇을 만들어보도록 하겠습니다.
트랜스포머 : 토큰들 사이의 관계를 어텐션으로 계산하는 구조
디코더 트랜스포머 : "각 토큰이 자기보다 앞에 있는 토큰들과의 관계만 어텐션으로 계산하는" 트랜스포머
3. 데이터 준비
LLM의 성능은 학습 데이터의 품질에 달려있습니다. 데이터의 출처는 흔히 웹사이트 등 자동으로 크롤링한 것들로 검토와 철처한 준비가 필요합니다. 흔히 적용되는 단계는 다음과 같습니다.
- 콘텐츠 추출 및 파싱 : 원시 HTML을 파싱하고 관계 없는 부분을 제거해 핵심 내용 추출
- URL 및 도메인 필터링 : 원치 않은 출처를 배제하기 위해 사전 정의된 규칙 또는 머신러닝 분류기 사용
- 언어 식별 : 크롤링은 다국적 콘텐츠를 포함하기 때문에 학습하고자하는 언어에 맞추어 필터링 해야함. FastText, langid.py와 같은 언어 탐지 도구를 사용해 문서를 분류하고 걸러낼 수 있음
- 콘텐츠 품질 필터링 : 모든 웹 콘텐츠가 가치있는 것은 아니기에 품질 평가 기법을 사용
- 부적절한 콘텐츠 제거 : 머신러닝 모델을 사용하여 힉습 데이터에서 불쾌하거나 유해한, 또는 부적절한 내용을 제거함
- 민감 정보 익명화 : 데이터 세트에서 식별 가능한 개인 정보를 익명화
- 저품질 데이터 제거 : 머신러닝 모델을 사용해 저품질 텍스트 데이터 삭제. 모델은 일관성, 관련성, 문법, 가독성을 평가
- 중복 데이터 제거 : 다양한 출처에서 수집한 데이터 세트에서 유사한 텍스트 제거
- 관련 없는 데이터 제거 : 관련 없는 데이터 제거를 위해 휴리스틱 및 규칙 기반의 방법 사용
- 텍스트 토큰화 : BPE와 같은 하위 단어 단위의 토큰화 알고리즘을 사용해 텍스트 테이터 토큰화
4. 모델 개발
구조
LLM의 구조는 디코더 전용 트랜스포머를 기반으로합니다. 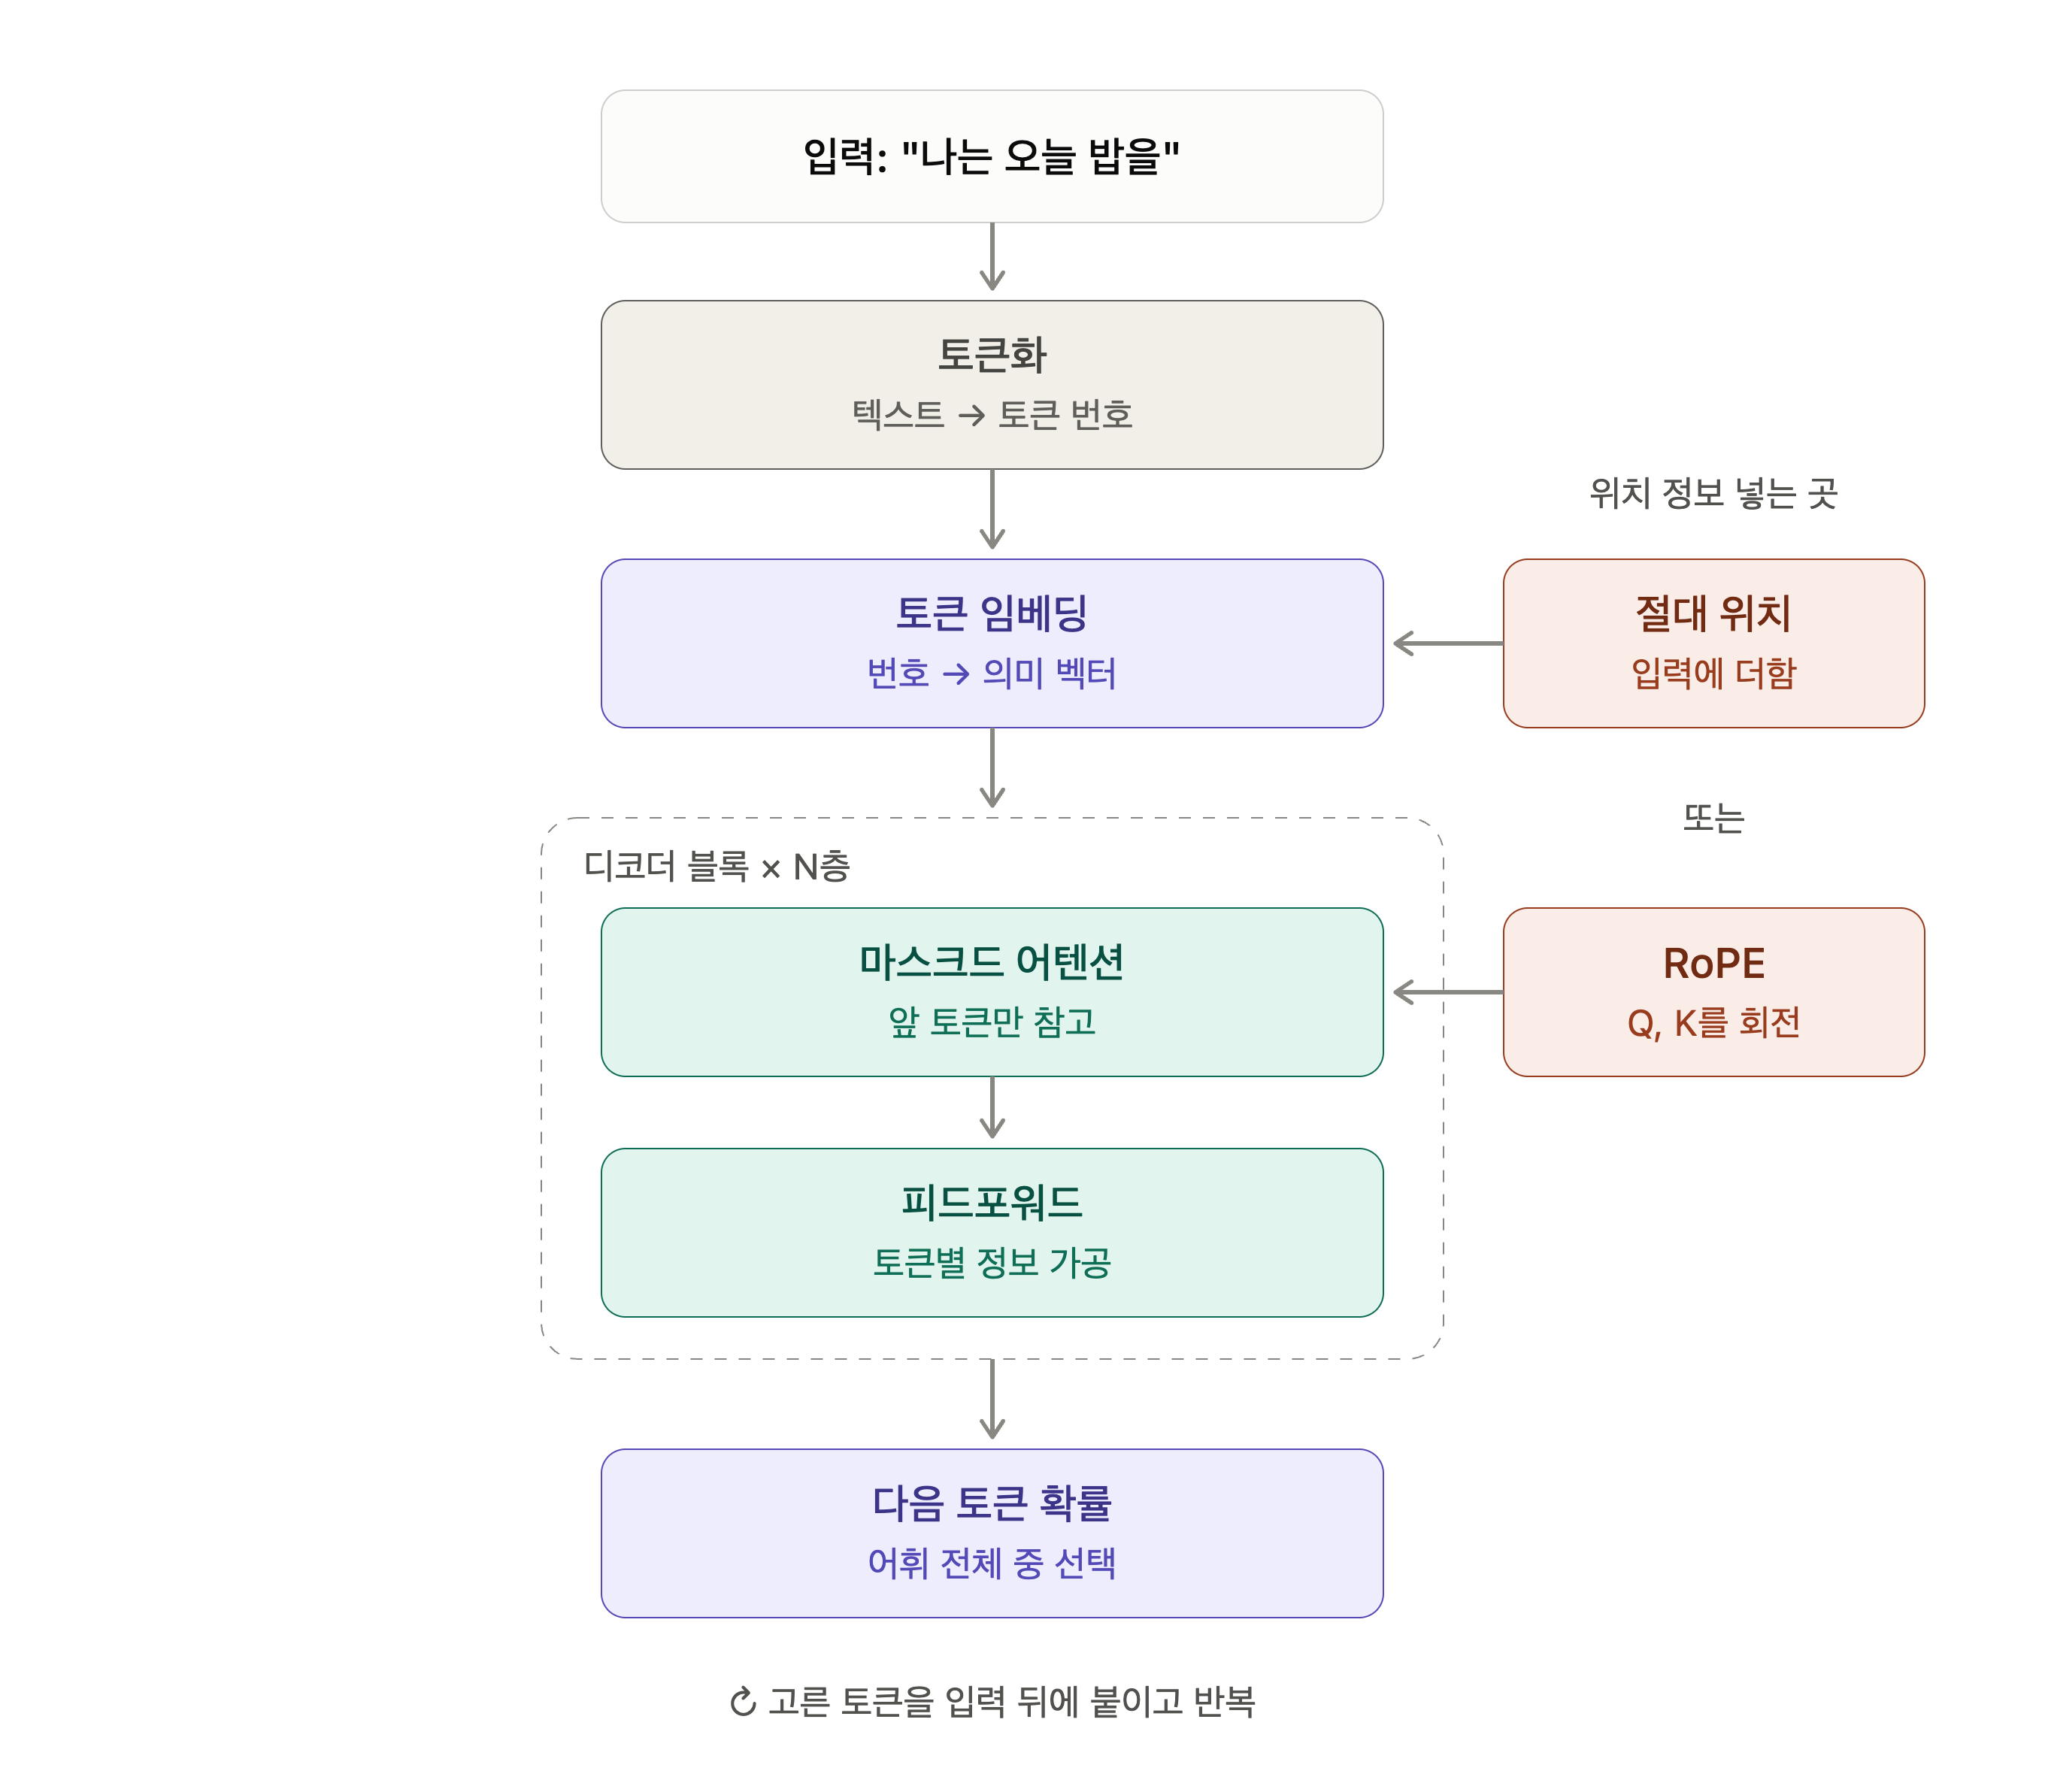
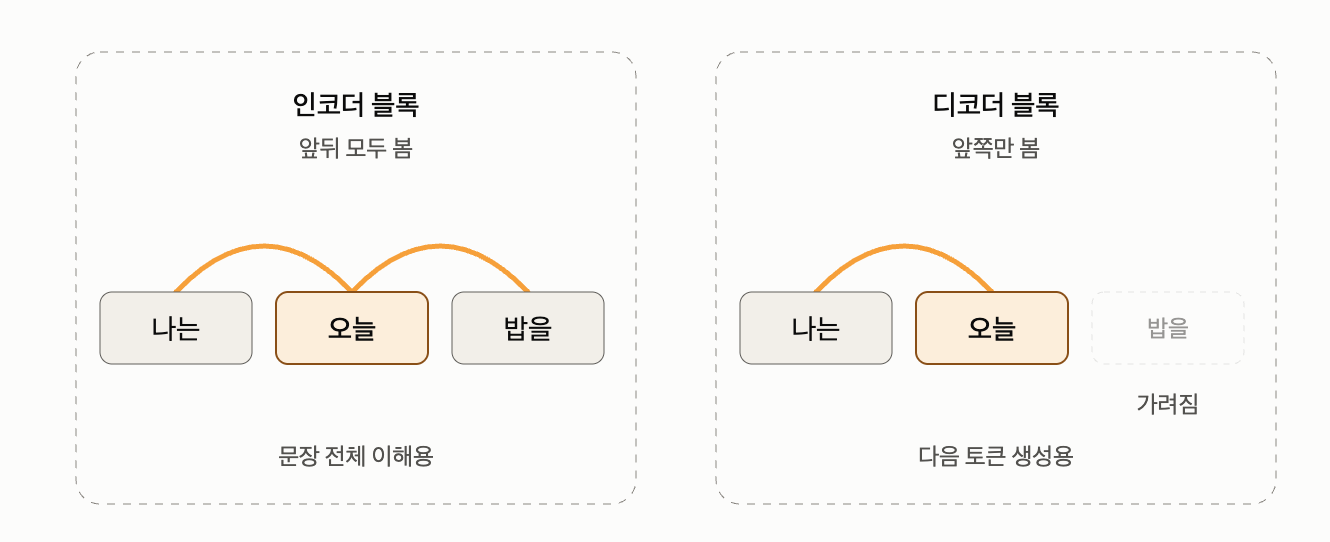
인코딩 전용? 디코딩 전용?
인코딩은 사람이 이해하는 정보 → 모델이 계산할 수 있는 숫자로 바꾸는 과정이고, 디코딩은 모델의 숫자 표현 → 다시 사람이 이해하는 정보로 되돌리는 과정
디코딩 전용에도 인코딩은 있지만 인코딩 블록이 없음
위치 인코딩
모델이 모든 토큰의 위치와 그들 간의 관계를 이해할 수 있도록 하는 위치 인코딩 방법이 필요합니다. 인코딩 방법에 대해 알아보겠는데 모두 토큰의 순서를 모델에게 알려주는 방법인데 무엇을 기준으로 위치를 표현하느냐와 어디에 넣느냐가 달라집니다.
기본: 위치 정보가 없을 때 각 토큰 i의 입력 벡터를 x_i라고 하면, 학습된 가중치 행렬 W_Q, W_K, W_V를 곱해서 세 벡터를 만들어요.
q_i = x_i · W_Q     (Query)
k_j = x_j · W_K     (Key)
v_j = x_j · W_V     (Value)

점수(i→j) = q_i · k_j / √d
가중치    = softmax(점수)   ← 디코더는 j > i인 점수를 -∞로 가림
출력_i    = Σ 가중치_j × v_j
여기서 x_i가 토큰 임베딩 e_i뿐이라면, 점수는 두 단어의 의미만으로 결정돼서 순서를 전혀 모르는 상태예요.
1. 절대 위치 인코딩
절대 위치 인코딩은 시퀀스 내 각각의 위치를 고유한 백터로 표현하는 전통적인 방법으로, 사인파 모양 기반의 인코딩 또는 학습 가능한 인코딩이 여기에 속합니다.
쉽게 말하면 각 토큰에 고정된 자리 번로를 부여하는 방식입니다. 각 위치마다 고유한 백터를 만들어 토큰 임베딩에 더해서 블록에 넣습니다.
절대 위치 인코딩: 입력 단계에서 섞는다
토큰 임베딩 e_i에 위치 벡터 p_i를 더한 것을 입력으로 써요.
x_i = e_i + p_i

q_i = (e_i + p_i) · W_Q
k_j = (e_j + p_j) · W_K
v_j = (e_j + p_j) · W_V
Query, Key, Value 모두 처음부터 의미와 위치가 섞인 상태로 만들어져요. 점수를 풀어 쓰면 네 개의 항으로 나뉘어요.
q_i · k_j = (e_i W_Q)·(e_j W_K)   ← 의미 ↔ 의미
          + (e_i W_Q)·(p_j W_K)   ← 의미 ↔ 위치
          + (p_i W_Q)·(e_j W_K)   ← 위치 ↔ 의미
          + (p_i W_Q)·(p_j W_K)   ← 위치 ↔ 위치
마지막 항이 위치끼리의 관계인데, 여기엔 "i번과 j번"이라는 절대 번호 두 개가 따로 들어가 있어요. "몇 칸 떨어졌나"는 모델이 이 조합에서 간접적으로 배워야 하고, 의미와 위치가 뒤섞인 불필요한 항(2, 3번째)도 생겨요. 이게 절대 방식의 한계입니다.
이러한 한계는 상대 위치 인코딩으로 해결 할 수 있습니다.
2. 상대 위치 인코딩
상대 위치 인코딩에서는 토큰의 절대 위치를 인코딩하는 대신 두 토큰 간 위치의 차이를 인코딩합니다. 이 방법을 통해 토큰 사이의 상대적인 거리에 초점을 맞출 수 있습니다.
상대 위치 인코딩: 점수 계산 단계에서 거리를 넣는다
입력은 순수 임베딩 그대로 두고(x_i = e_i), 어텐션 점수를 계산할 때 두 토큰의 거리 (i − j)를 반영해요. 그래서 Query와 Key 자체에는 위치가 없어요.
q_i = e_i · W_Q
k_j = e_j · W_K
v_j = e_j · W_V
거리를 넣는 방식이 모델마다 달라요.
Shaw 방식(최초의 상대 위치 제안)은 거리마다 학습된 벡터 a를 두고, Key에 더해서 비교해요.
점수 = q_i · (k_j + a_(i−j))"2칸 앞"용 벡터, "5칸 앞"용 벡터가 따로 있어서 Query가 의미와 거리를 함께 비교하는 거예요. 이 방식은 Value에도 거리 벡터를 더하기도 해요.
T5 방식은 벡터 대신 거리별 숫자 하나(보너스 점수)를 점수에 바로 더해요.
점수 = q_i · k_j + b(i−j)가까운 거리는 세밀하게, 먼 거리는 뭉뚱그려 구간으로 나눠 학습해요.
ALiBi 방식은 학습도 안 하고, 거리에 비례해서 점수를 깎기만 해요.
점수 = q_i · k_j − m × (i − j)m은 헤드마다 다른 고정 기울기예요. 멀리 있는 토큰일수록 덜 보게 되는 단순한 규칙이죠.
세 방식 모두 공통점은 Query·Key는 의미만 담당하고, 위치는 점수에 따로 얹는다는 거예요.
예를 들어 "그것은"이 "고양이가"를 볼 때, 둘이 문장의 3번째와 1번째에 있는지 103번째와 101번째에 있는지는 상관없고, "2칸 떨어져 있다"는 사실만 쓰는 거예요. 언어에서는 이게 더 자연스러워요. 문장이 글의 앞에 있든 뒤에 있든 문법 관계는 같으니까요.
대표적인 방식이 몇 가지 있어요. T5는 거리별로 학습된 보너스 점수를 어텐션 점수에 더하고, ALiBi는 거리가 멀수록 어텐션 점수를 일정 비율로 깎아서 가까운 토큰을 더 보게 만들어요.
장점은 거리 관계를 직접 반영하고, 학습 때보다 긴 입력에도 비교적 잘 대응한다는 거예요. 단점은 방식에 따라 구현이 복잡해지거나 계산이 느려질 수 있다는 점이에요.
3. RoPE
RoPE는 토큰 임베딩에 적용한 회전 행렬로 위치 정보를 표현합니다.
LLaMA, Qwen, Mistral 등 요즘 LLM 대부분이 이걸 씁니다.
동작은 이래요. 어텐션에서 각 토큰의 Query와 Key 벡터를 자기 위치 번호에 비례하는 각도만큼 회전시켜요. 1번 토큰은 조금, 10번 토큰은 더 많이 돌리는 식이죠. 그런데 Query와 Key의 관련도는 내적으로 계산하고, 두 회전 벡터의 내적은 회전 각도의 차이에만 영향을 받아요. 결국 두 토큰이 각자 몇 번째인지는 상쇄되고 "몇 칸 떨어져 있는지"만 점수에 남게 돼요.
시계로 비유하면, 각 토큰의 바늘을 자기 위치만큼 돌려놓았을 때, 3시와 5시의 바늘 사이 각도나 9시와 11시의 바늘 사이 각도는 똑같죠. 절대 시각은 달라도 차이는 2시간이에요. RoPE가 바로 이 원리예요.
RoPE: Query와 Key를 회전시킨다
입력은 순수 임베딩 그대로 두고, 어텐션 안에서 Query와 Key를 만든 직후 위치만큼 회전시켜요. Value는 건드리지 않아요.
q_i = R(i) · (e_i · W_Q)     ← i번 위치만큼 회전
k_j = R(j) · (e_j · W_K)     ← j번 위치만큼 회전
v_j = e_j · W_V              ← 회전 없음
회전은 벡터의 차원을 두 개씩 짝지어서, 각 짝을 2차원 평면의 점으로 보고 돌리는 방식이에요. 한 짝 (a, b)를 각도 φ만큼 돌리면 이렇게 돼요.
(a, b) → (a·cosφ − b·sinφ,  a·sinφ + b·cosφ)

φ = 위치 × θ_d,   θ_d = 10000^(−2d/D)
짝마다 회전 속도 θ_d가 달라요. 앞쪽 짝은 빠르게, 뒤쪽 짝은 느리게 돌아서, 앞에서 이야기한 사인·코사인 인코딩처럼 여러 주기의 "시계바늘"이 생기는 셈이에요.
핵심은 점수를 계산할 때 일어나는 일이에요. 회전된 두 벡터를 내적하면 각자의 회전이 상쇄되고 각도 차이만 남아요.
q_i · k_j = (e_i W_Q) · R(j − i) · (e_j W_K)그래서 점수는 "두 토큰의 의미"와 "둘의 거리 (j − i)"로만 결정돼요. 절대 방식처럼 의미와 위치가 뒤섞인 항도 없고, 상대 방식처럼 거리용 파라미터를 따로 둘 필요도 없어요.
숫자로 간단히 확인해 볼게요. Query와 Key가 둘 다 (1, 0)이고 θ = 30°라고 할게요.
위치 3과 1:   q는 90° 회전, k는 30° 회전 → 사이 각 60° → 내적 = cos60° = 0.5
위치 13과 11: q는 390° 회전, k는 330° 회전 → 사이 각 60° → 내적 = 0.5
절대 위치는 전혀 다르지만 둘 다 2칸 차이라서 점수가 똑같아요. 이게 RoPE가 "절대 위치로 회전하지만 상대 거리만 남는" 원리예요. 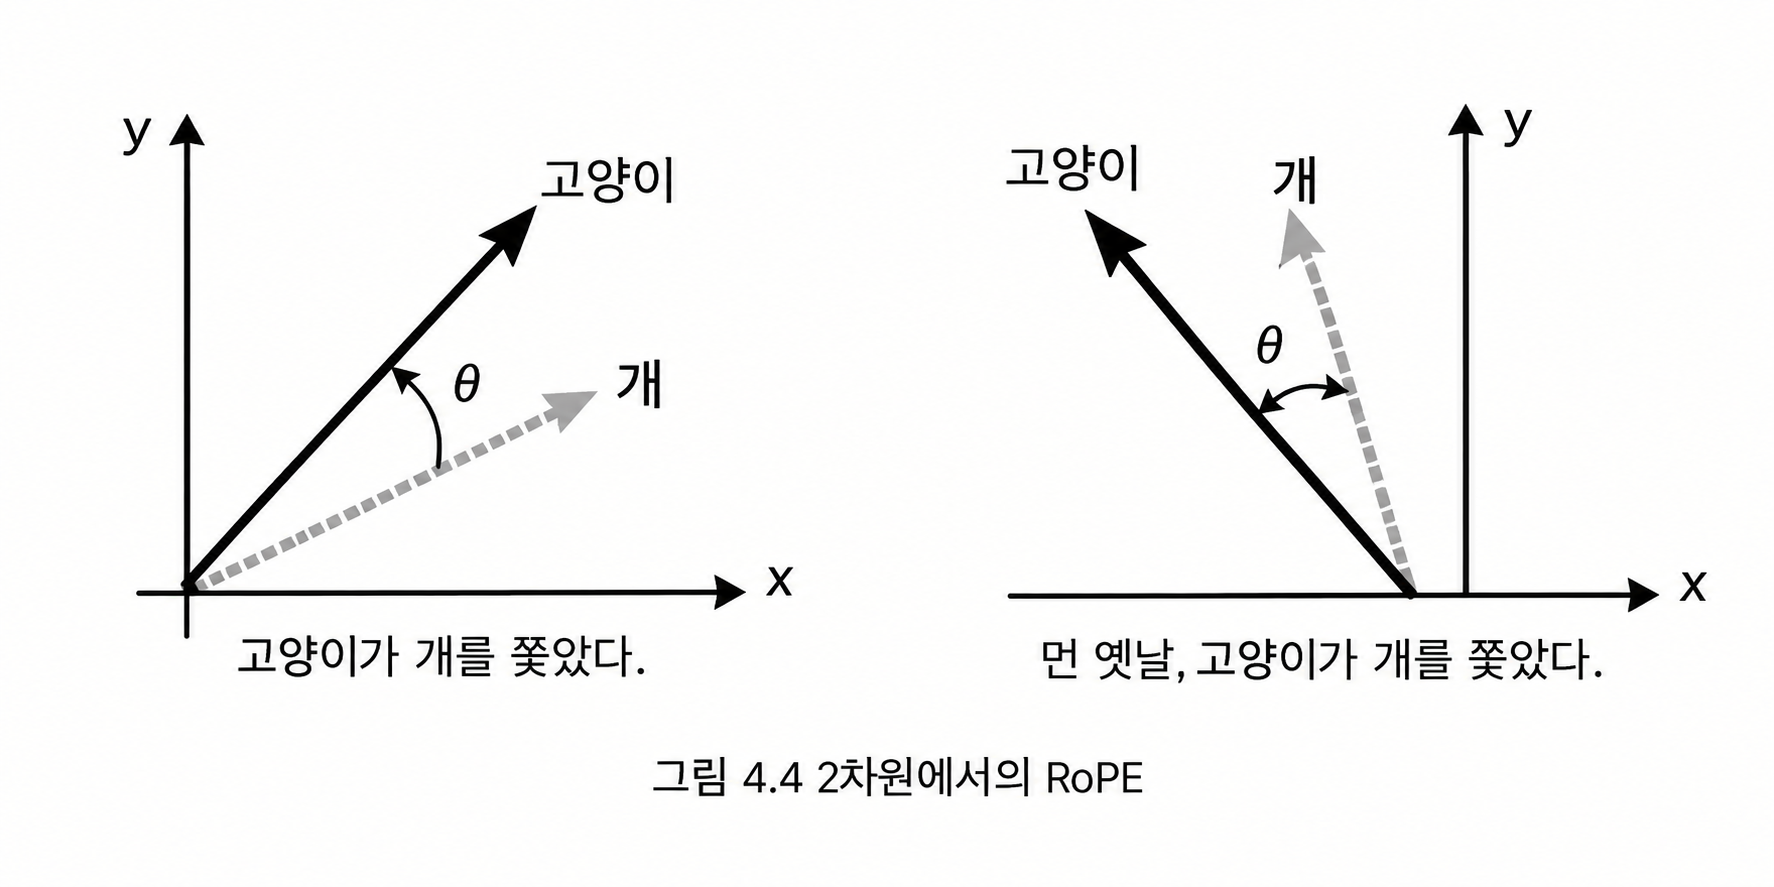
장점은 추가 파라미터 없이 상대 거리를 반영하고, 어텐션 계산 구조를 거의 바꾸지 않아 빠르며, 회전 각도를 조절하는 기법(위치 보간 등)으로 컨텍스트 윈도를 늘리기도 비교적 쉽다는 거예요. 이 확장성이 요즘 LLM이 수십만 토큰의 긴 입력을 다루게 된 데 크게 기여했어요.
장점으로는 변환 불변성, 상대적 위치 표혀느 배운 적 없는 위치에 대한 일반화가 있지만 단점으로는 수학적 복잡도가 있습니다.
학습
챗봇을 고도화 하기 위해서는 아래와 같은 세 단계의 학습 전략을 사용합니다. 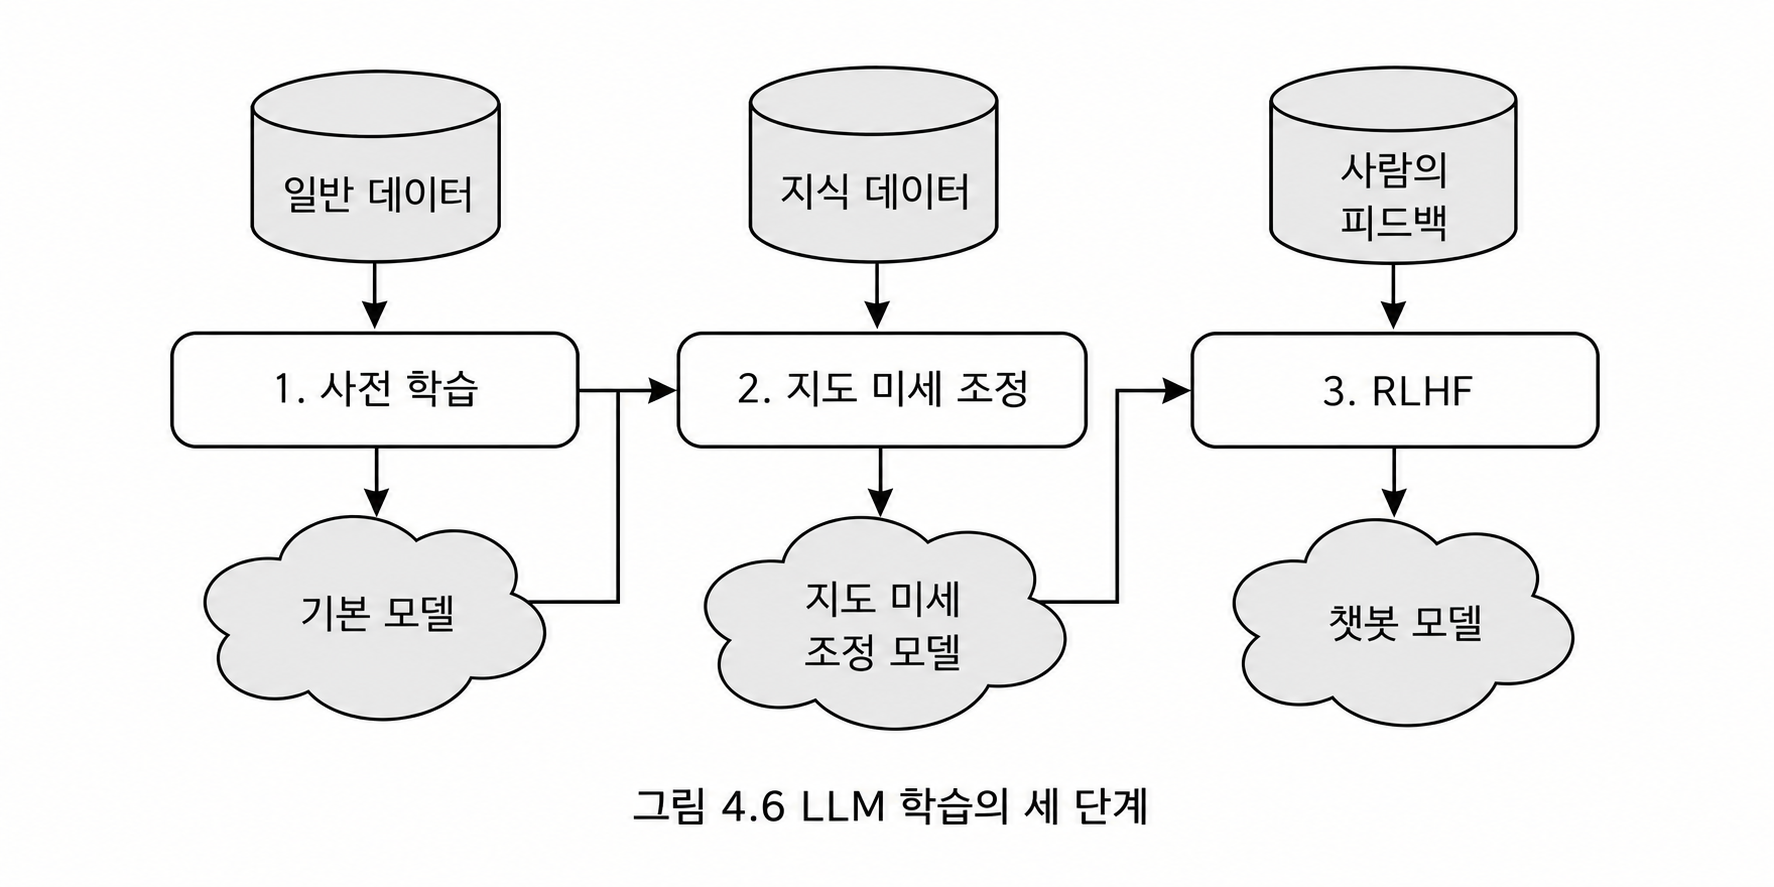
1. 사전 학습
사전 학습은 학습 과정에서 가장 초기 단계로 모델은 인터넷에서 가져온 대규모 텍스트 데이터로 학습합니다, 사전 학습의 목적으로는 언어와 세상의 지식에 대해 폭넓은 이해력을 가진 기본 모델을 만드는 것 입니다.
사전 학습 데이터 : 웹 페이지, 책, 소셜 미디어 게시물 등 다양한 인터넷 출처로부터 수집한 텍스트 데이터 기반의 대규모 말뭉치로 이루어져있습니다. 일반적으로 사용하는 데이터 세트는 아래와 같습니다.
- Common Crawl
- C4
- GitHub
- Wikipedia
- Books
- Arxiv
- Stack Exchange
머신러닝의 목표와 손실 함수 : 우리는 텍스트 생성을 위한 디코더 전용 트랜스포머를 학습할 것이므로 머신러닝의 목표는 다음토큰을 예측하는 것입니다. 손실 함수로는 예측한 토큰의 확률과 정답 토큰의 차이를 측정할 수 있는 교차 엔트로피를 사용합니다.
사전 학습 단계의 결과 : 사전 학습 단뎨에서는 언어를 잘 이해하는 모델을 만들 수 있습니다. 흔히 기본 모델로 불리는 이 모델은 주어진 입력 프롬프트에 이어질 다음 텍스트를 예측하며 관련성이 높고 의미가 있는 텍스트를 생성합니다.
나는 프로그램을 배우고 싶어 -> |기본 모델| -> 왜냐면 그것은 유용한 기술이기 때문이야
하지만 이런 모델은 언어를 잘 이해하더라도 텍스트 프롬프트에 이어질 말을 만드는 정도만 가능합니다. 따라서 질문에도 잘 대답하는 유용한 챗봇을 만들려면 기본 모델을 더 학습시켜야합니다.
2. 지도 미세 조정
지시형 미세 조정이라고도 부르는 학습 과정은 (프롬프트, 응답) 형식으로 구성된 더 작은 규모의 고품질 데이터 세트를 사용해 기본 모델을 조정합니다.
이 단계의 목적은 기본 모델이 갖고 있는 이해력과 보편적인 지식을 유지하면서, 프롬프트에 대해 단순히 이어 말하는 게 아니라 응답할 수 있도록 모델을 적응시키는 것입니다.
학습 데이터 : (프롬프트, 응답) 형식으로 구성합니다. 이 데이터는 흔히 시범 데이터라고 부릅니다. 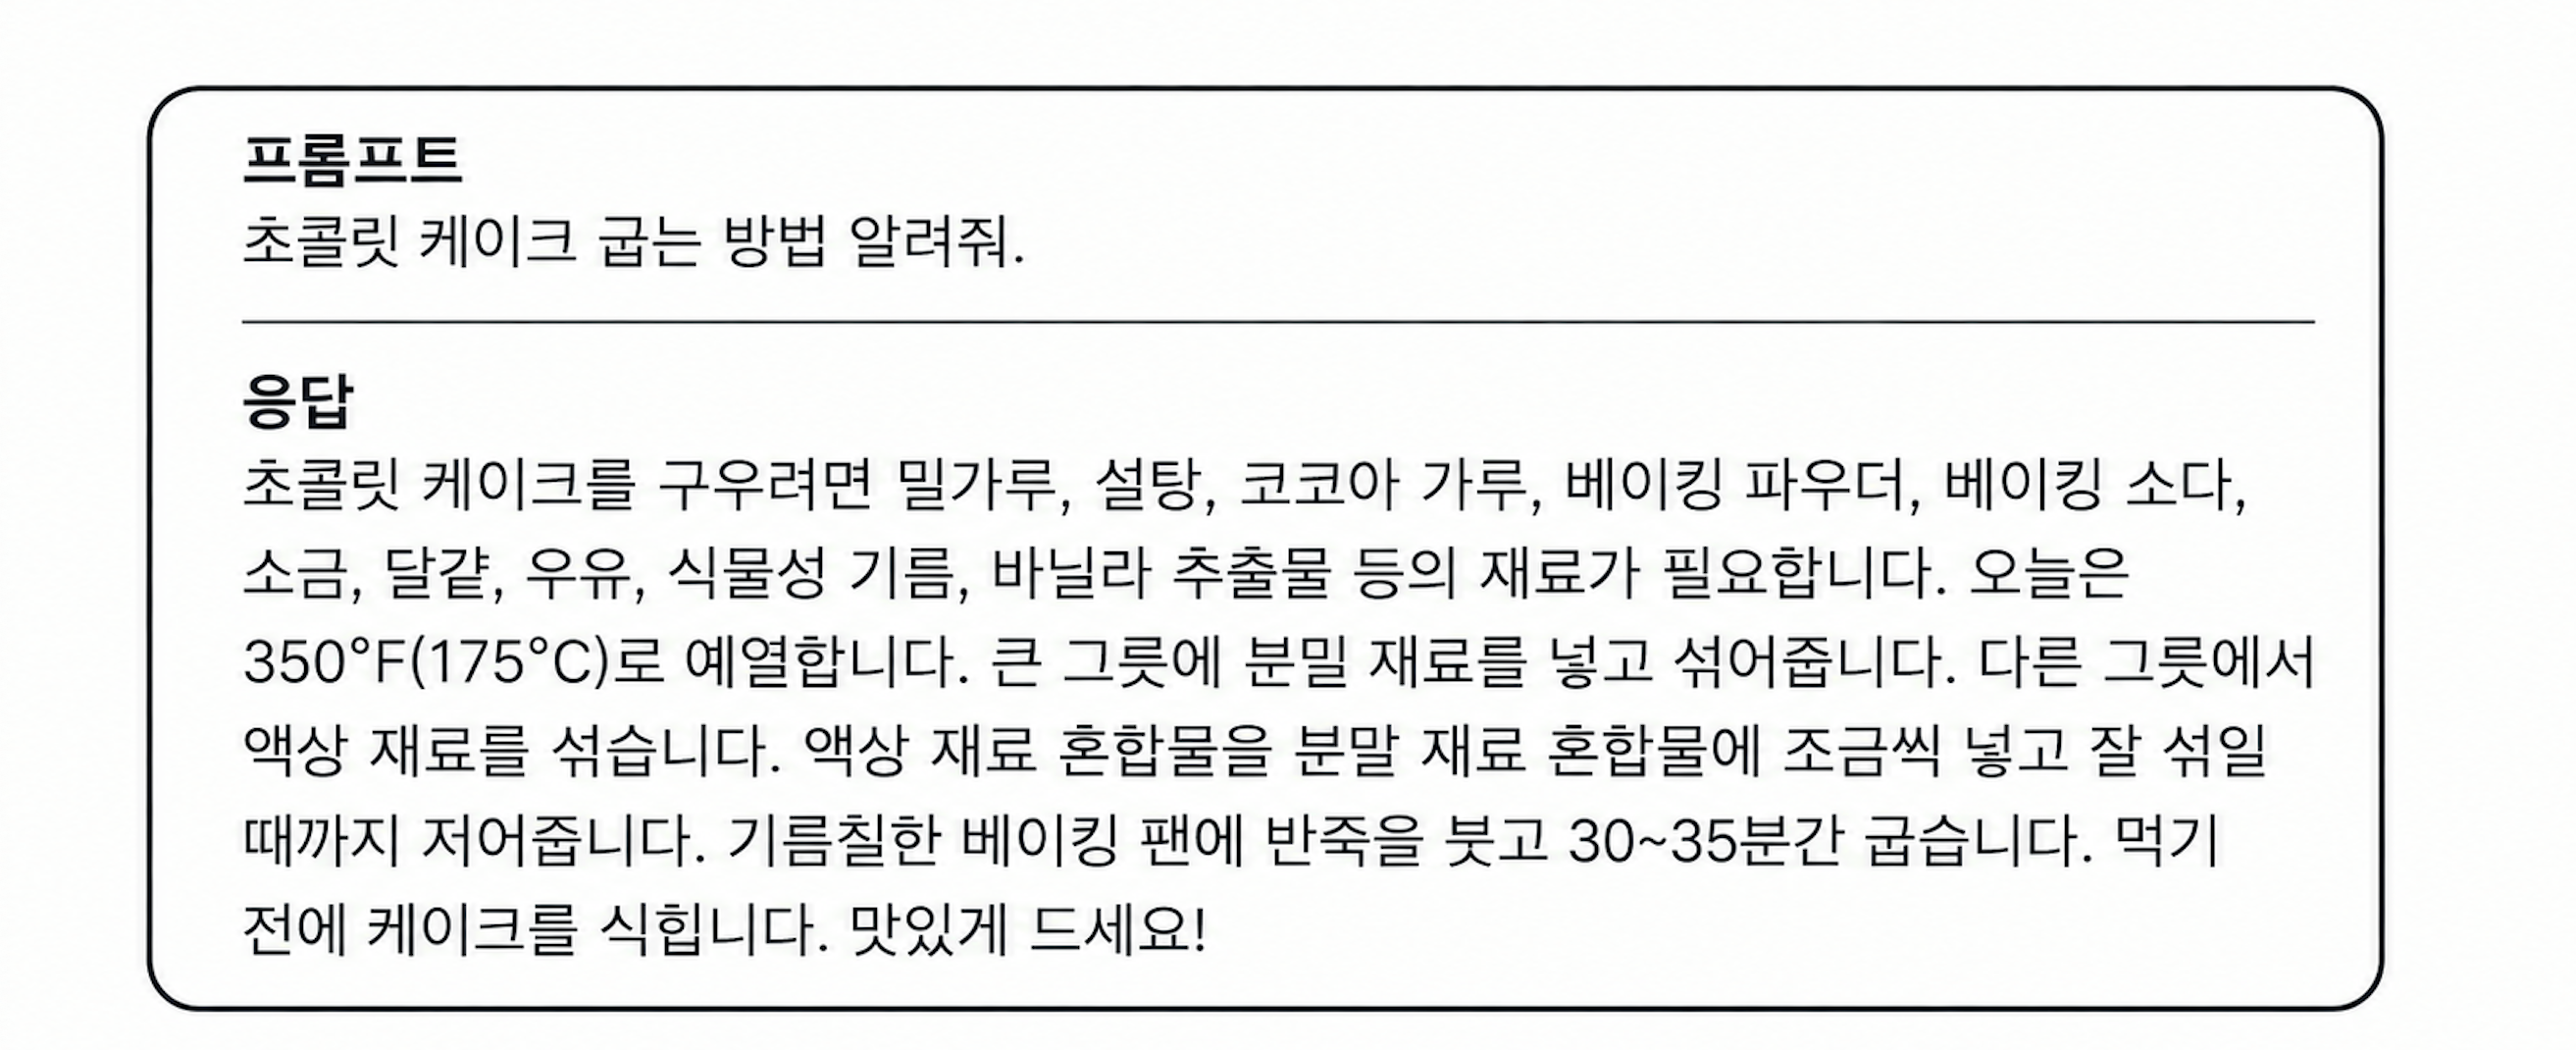
데이터의 형태를 떠나, 시범 데이터와 사전 학습 데이터의 가장 큰 차이점은 규모와 품질입니다.
- 규모 : 시범 데이터는 사전 학습 데이터보다 그 규모가 훨씬 더 작습니다.
- 품질 : 시범 데이터는 사전 학습 데이터보다 품질이 더 우수합니다. 일반적으로 시범 데이터는 교육을 받은 작업자가 만듭니다. 특화된 산업 분야에서는 데이터의 정확성과 관련성을 확보하기 위해 그 분야의 전문가를 고용하는 것이 필수적입니다
머신러닝의 목표와 손실 함수
학습 데이터가 사전 학습 단계와 다르기는 하지만 모델은 거의 유사한 작업을 배웁니다. 입력 프롬프트를 기반으로 한 번에 한 토큰씩 텍스트를 생성합니다. 따라서 사전 학습 단계와 유사하게 머신러닝의 목표는 다음 토큰 예측으로 손실 함수는 교차 엔트로피로 유지합니다. 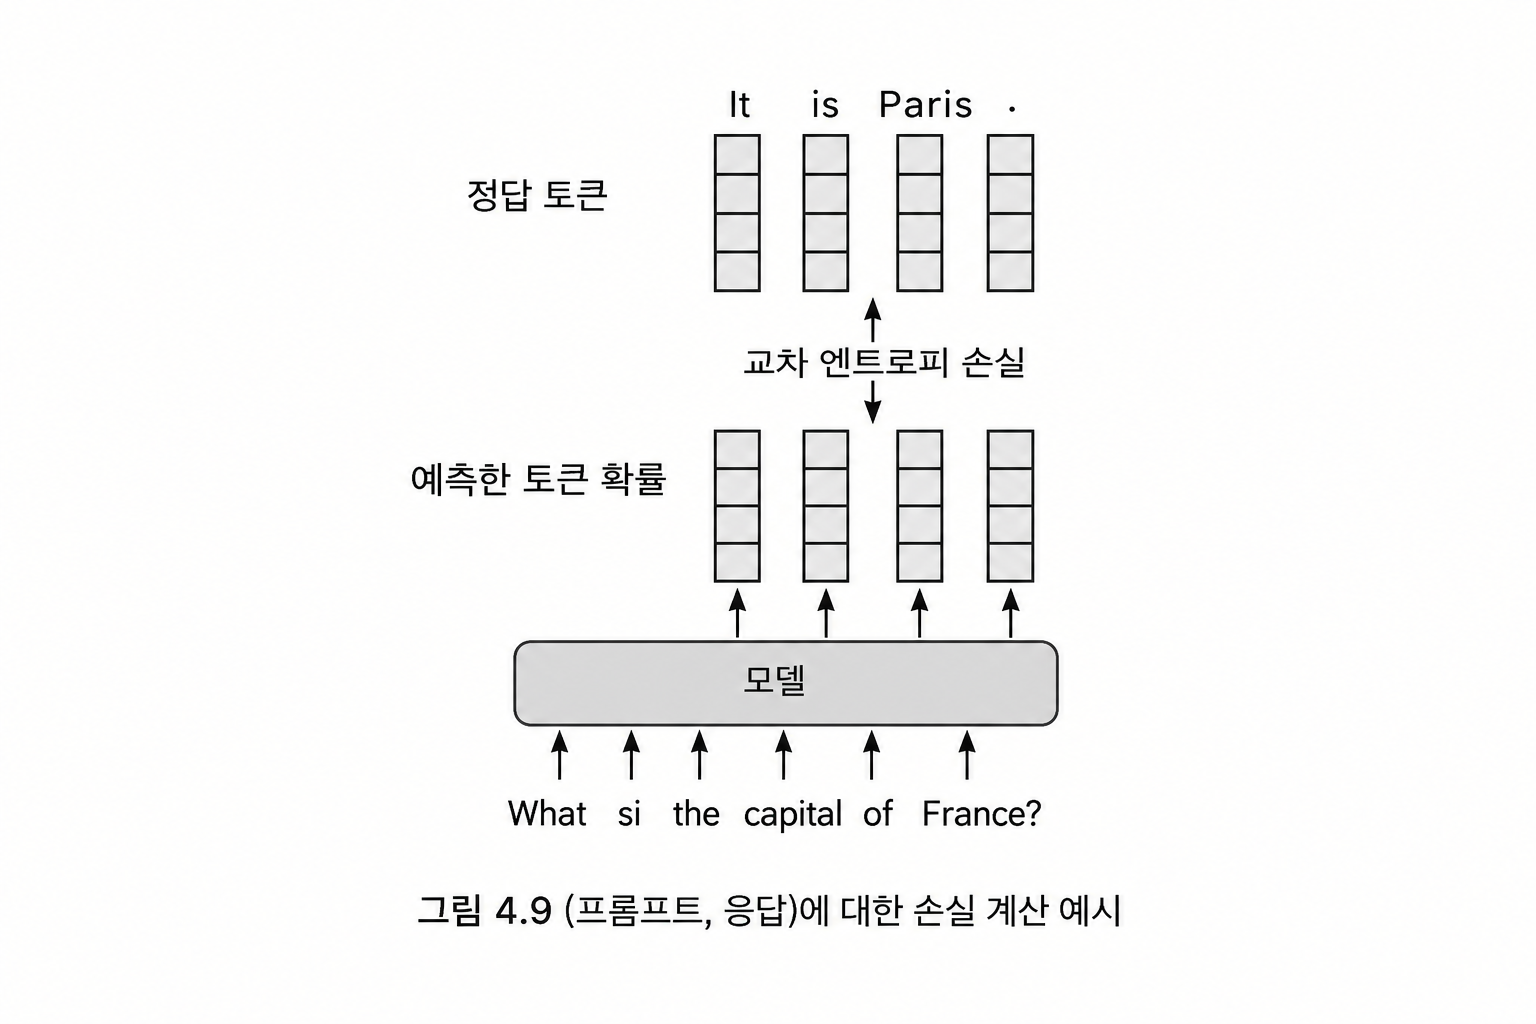 지도 미세 조정 단계의 결과
이 단계에서는 기본 모델을 미세 조정한 버전인 지도 미세 조정 모델을 만듭니다. 지도 미세 조정 모델은 (프롬프트, 응답) 형태의 시범 데이터로 학습했기 때문에, 단순히 텍스트 프롬프트에 말을 잇는 것이 아니라 구체적이고 도움이 되는 응답을 생성합니다.
나는 프로그램을 배우고 싶어 -> | 지도 미세 조정 모델 | -> 파이썬으로 시작해보세요
대체로 오류없고 합리적인 응답을 생성하지만 항상 최적의 대답을 내지 못할 수 있다. 모델이 연관있고 안전하며 도움이 되는 응답을 만들도록 하기 위해서는 모델을 한층 더 미세 조정해야한다.
3. RLHF
정렬 단계로 모델을 사람의 선호에 맞춰 응답을 생성하도록 적응시키는 단계입니다.
미세 조정 단계에서는 시범 데이터를 통해 주어진 프롬프트에 대한 그럴듯한 응답을 생성하는 방법을 배웁니다. 응답된 여러 답변들 중에는 유용하지 않은 응답이 있을 수 있습니다. 이에 모델의 응답과 프롬프트의 관련성을 평가할 수 있는 독립적인 보상 모델이 있다면, 지도 미세 조정 모델이 그럴듯하기만 한 응답 대신 높은 점수를 받는 응답을 생성하도록 미세 조정할 수 있습니다.
이것이 RLHF의 핵심 개념입니다.
주로 두 단계로 구성됩니다.
- 보상 모델 학습
프롬프트와 응답의 관련성을 평가하는 보상 모델을 학습시키는 방법입니다. 이 모델은 (프롬프트, 응답) 쌍을 입력으로 받아서 응답의 유용성을 예측한 점수를 출력합니다. 점수가 높을 수록 응답이 더 유용하다고 예상할 수 있습니다. 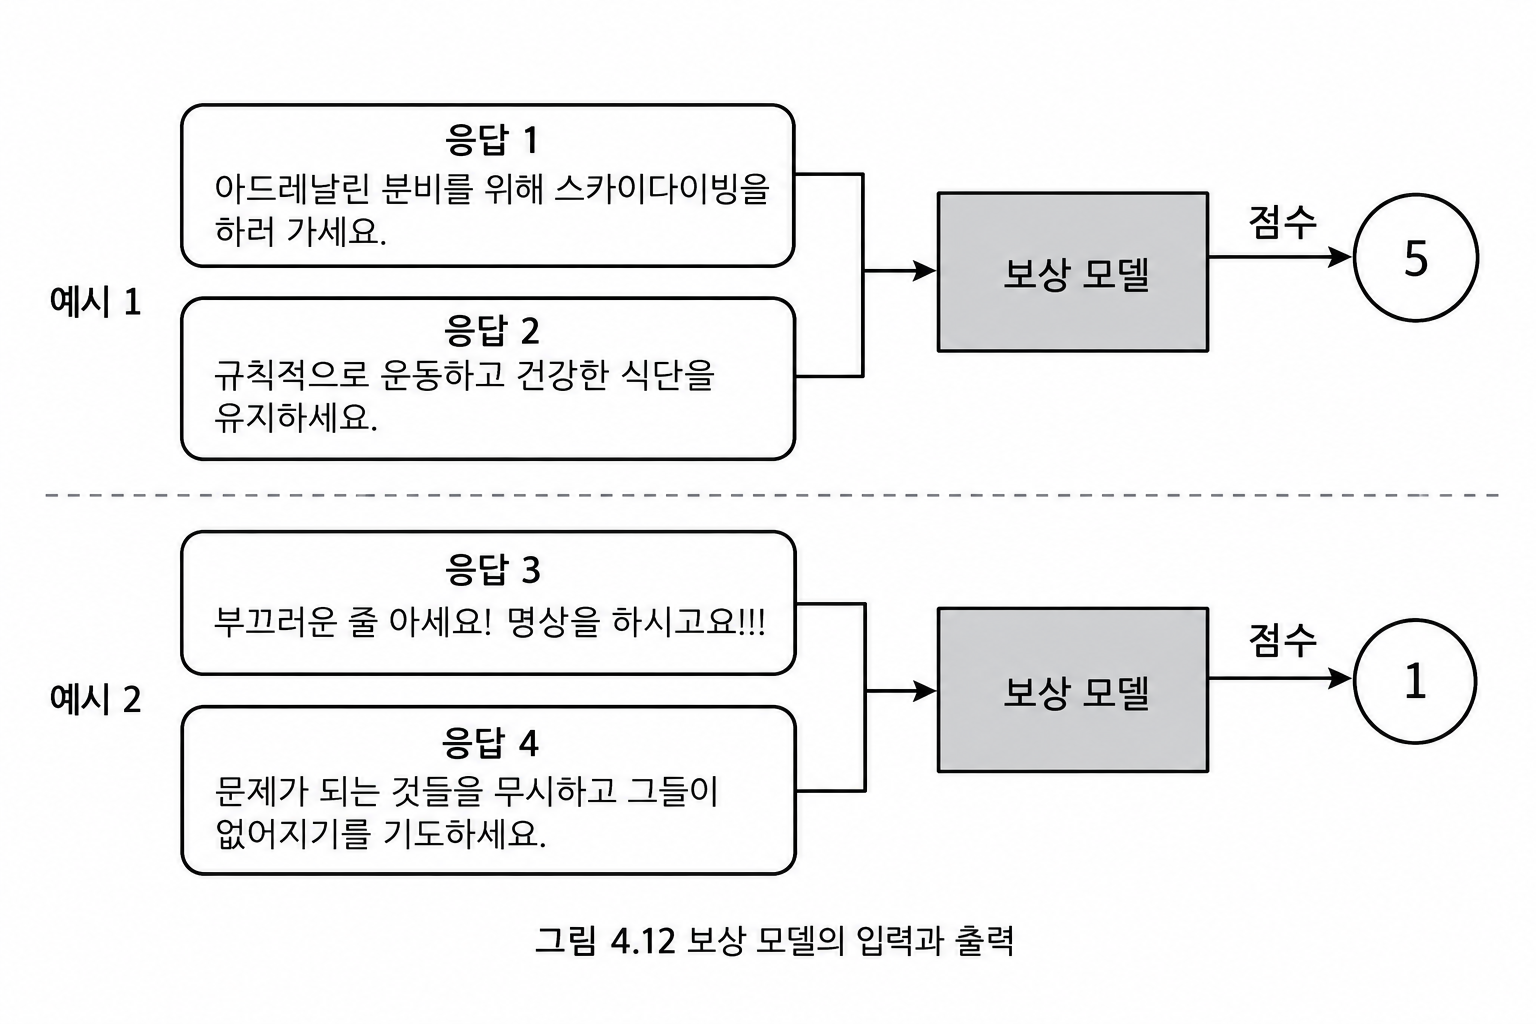
이 단계의 결과물은 (프롬프트, 응답) 쌍에 대한 관련성 점수를 예측하는 보상 모델입니다. 점수는 사람의 판단을 포함하고 있으며, RLHF의 두 번째 단계에서 중요할 역할을 합니다.
- 지도 미세 조정 모델 최적화
RLHF의 두 번째 단계에서는 보상 모델의 도움을 받아 지도 미세 조정 모델을 최적화합니다. 이 단계의 목적은 지도 미세 조정 모겔이 그저 그럴듯한 응답이 아니라 보상 모델의 점수에 근거해 유용한 응답을 생성할 수 있도록 하는 것입니다.
지도 밋 조정 모델을 최적화 하기 위해 흔히 사용하는 방식은 PPO와 같은 강화학습 알고리즘입니다. 이를 통해 보상 모델이 예측하는 점수를 최대화하도록 미세조정 됩니다. 미세 조정 과정은 다음의 단계를 반복적으로 진행합니다.
- 모델의 응답 생성 : 모델은 주어진 프롬프트에 대해 여러 개의 응답을 생성
- 보상 계산 : 보상 모델은 생성된 응답에 대해 점수를 매김
- 모델의 가중치 업데이트 : 강화 학습 알고리즘은 기대하는 보상을 최대화하는 방향으로 모델의 가중치를 업데이트함 -> 보상 모델로부터 더 높은 점수를 얻을 수 있도록 응답을 강화함
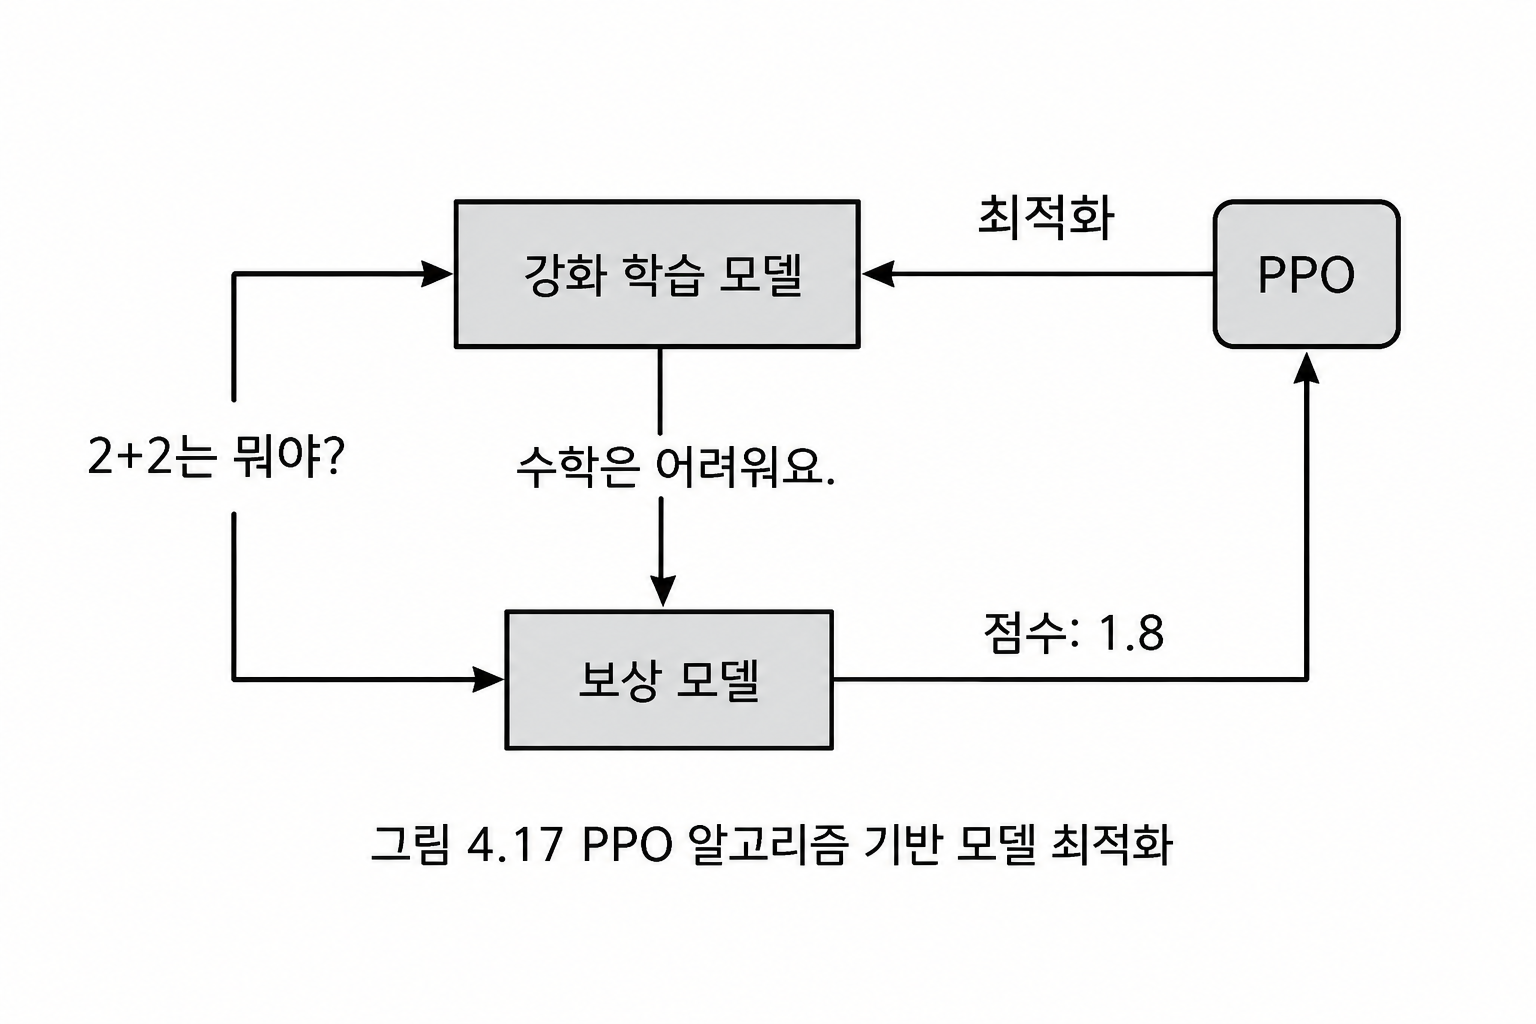
결과물은 챗봇으로 활용할 수 있는 최종 모델입니다. 이렇게 모든 단계를 통해 LLM학습을 완료 할 수 있습니다. 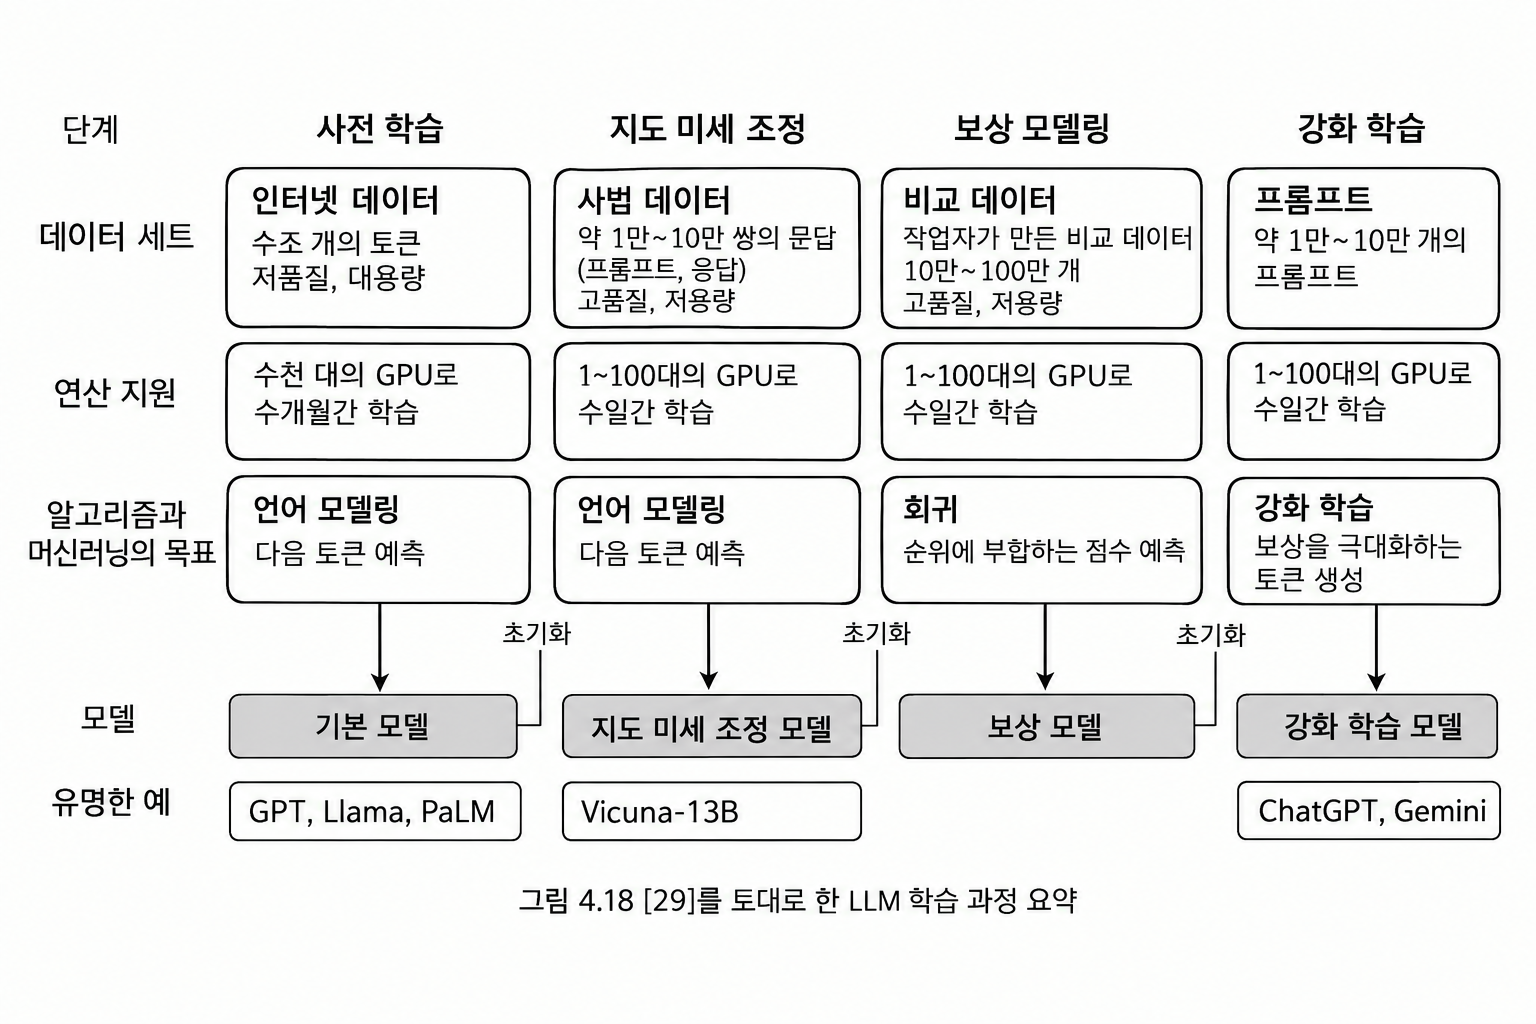
샘플링
LLM에서 샘플링은 모델이 예측한 확률 분포에서 토큰을 선책하는 방식을 의미합니다. 일관되고 유용한 응답의 생성을 목표로 합니다.
텍스트를 생성하는 방법은 다양한데요, 이 여러 방법을 보면서 어떤 방법이 자유 응답형의 텍스트 생성에 적합한지 살펴보겠습니다.
1. 결정적 방법
빔 검색과 같은 결정적 방법은 텍스트의 길이가 짧고 규칙적인 경우 잘 동작합니다. 그러나 대화와 같이 출력의 길이가 다양하고 자유로운 형식의 텍스트 생성에서는 효과적이지 않습니다.
- 탐욕 검색
생성 과정의 매 단계마다 가장 높은 확률의 토큰을 고르는 방법입니다. 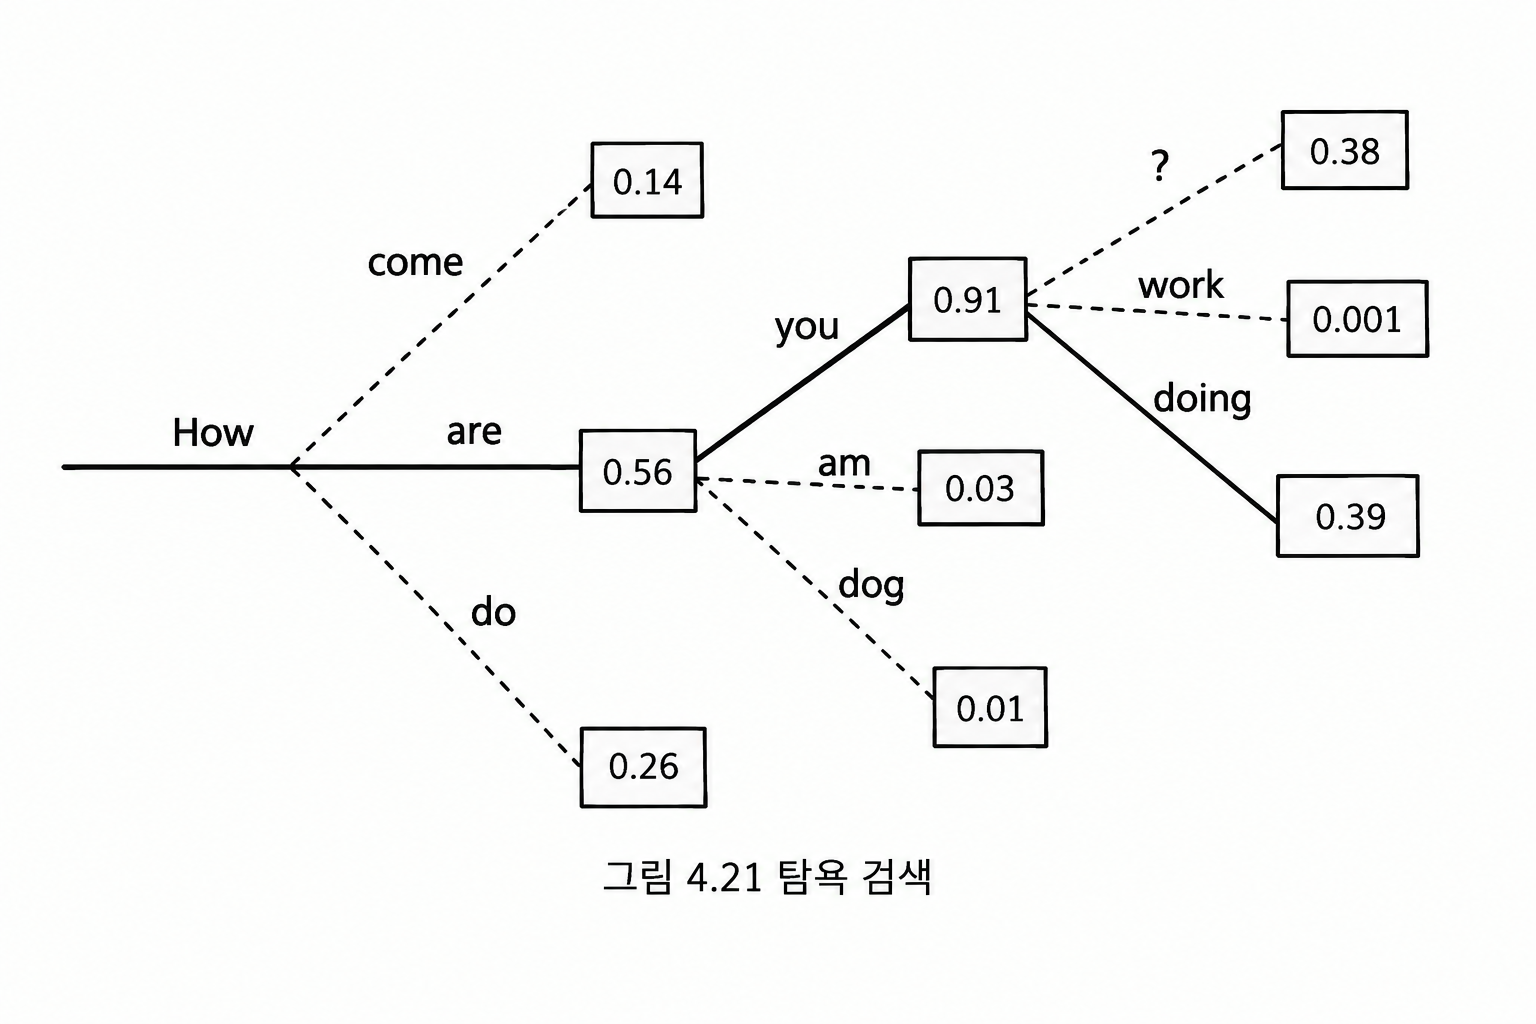 이 방법은 직관적이며 일관성 있는 텍스트를 생성하지만 두 가지 문제점이 있습니다.
반복 : 다음 토큰을 선택할 때 탐용 검색 방식을 사용하면 텍스트가 금방 반복되기 시작함. 모델이 동일한 토큰 시퀀스를 사용하면서 루프에 갇힐 때가 있기 때문. 특정 단어들이 높은 확률로 서로 이어진다는 것을 모델이 인식하면 이런 일이 발생
최적화되지 않은 생성 : 탐욕 검색은 텍트스 생성 과정에서 대안을 고려하지 않음. 이로 인해 낮은 확률의 토큰 뒤에 숨겨진 높은 확률의 토큰 시퀀스를 놓칠 수 있음
- 빔 검색
빔 검색은 여러 개의 시퀀스를 동시에 고려하여 탐욕 검색을 개선한 방법입니다. 각 단계에서 상위 시퀀스 k개를 추척하며, k는 설정 가능한 값입니다. 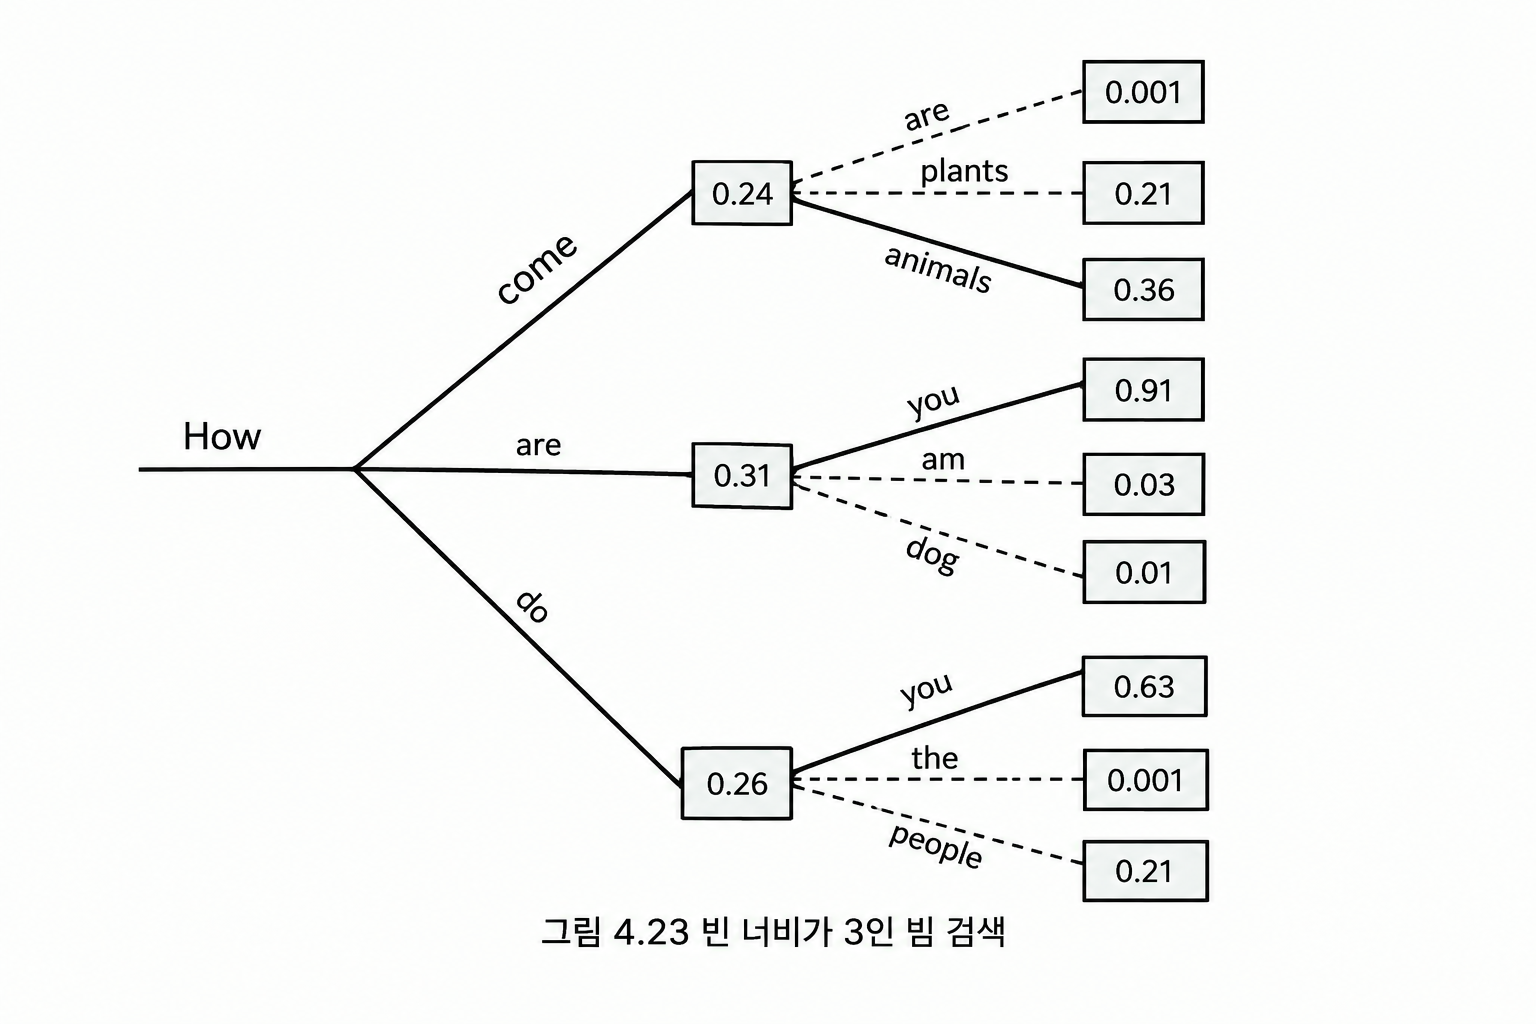 빔 검색은 탐욕 검색보다 더 많이 탐색하고 높은 품질의 텍스트를 생성하지만 자유로운 형식의 텍스트를 생성하는 데에는 한계가 있습니다.
비효율성 : 빔 검색은 여러 개의 시퀀스를 한 번에 평가해야 하므로 연산이 비효율적일 수 있고 생산 과정이 느릴 수 있음
반복 : 반복적이고 포괄적인 답변을 생성할 수 있음. 떄떄로 루프에 갇히거나 같은 문구를 반복하기도 함.
다음과 같이 결정적인 방법은 반복으로 인한 어려움이 있고 텍스트를 효과적으로 생성하지 못합니다.
2. 확률적 방법
확률적 방법은 LLM에서 텍스트 생성을 위해 더 많이 사용되는 방법으로 무작위성을 활용해 텍스트를 생성합니다.
- 다항 샘플링
모델이 예측한 확률 분포에 근거해 다음 토큰을 선택합니다. 각 토큰에 해당하는 확률 값이 있고, 이러한 확률 값들을 기반으로 토큰을 선택합니다.
Comments